بررسی جامع کاربرد یادگیری تقویتی در تحلیل مسابقات فوتبال، تصمیمگیری تاکتیکی، مدیریت سرمایه و بازارهای شرطبندی ورزشی
یادگیری تقویتی (Reinforcement Learning یا RL) یکی از سه شاخه اصلی یادگیری ماشین، در کنار یادگیری نظارتشده و بدوننظارت، است. برخلاف یادگیری نظارتشده که هدف آن پیشبینی برچسب دادههاست، RL بر تصمیمگیری متوالی (Sequential Decision-Making) تمرکز دارد؛ یعنی یک عامل (Agent) در محیطی پویا با انجام اقدامات مختلف، بازخورد (پاداش یا جریمه) دریافت میکند و میآموزد چگونه در بلندمدت بیشترین پاداش تجمعی را کسب کند.
این چارچوب، شباهت زیادی به فوتبال دارد. مربیان، بازیکنان، مدیران فنی و حتی تحلیلگران بازارهای شرطبندی، همگی با تصمیمهایی روبهرو هستند که پیامد آنها تنها به لحظه حاضر محدود نمیشود، بلکه بر رویدادهای آینده نیز اثر میگذارد. به همین دلیل، RL در سالهای اخیر به یکی از مهمترین حوزههای پژوهش در تحلیل ورزشی تبدیل شده است.
برخلاف برخی ادعاهای اغراقآمیز، شواهد علمی موجود نشان میدهد که RL هنوز جایگزین روشهای آماری و یادگیری نظارتشده نشده است. موفقیت آن به کیفیت داده، طراحی محیط، تعریف صحیح تابع پاداش و امکان شبیهسازی دقیق مسابقات بستگی دارد.
۱. یادگیری تقویتی چیست؟
در RL، یک عامل (Agent) با محیط (Environment) تعامل میکند.
در هر مرحله:
وضعیت (State) را مشاهده میکند.
یک اقدام (Action) انتخاب میکند.
پاداش (Reward) دریافت میکند.
به وضعیت جدید منتقل میشود.
هدف، یافتن سیاستی (Policy) است که مجموع پاداشهای آینده را بیشینه کند.
۲. تفاوت با یادگیری نظارتشده
در یادگیری نظارتشده:
ورودی → خروجی صحیح
وجود دارد.
اما در RL:
خروجی صحیح از قبل مشخص نیست.
عامل باید از طریق تجربه و آزمونوخطا یاد بگیرد.
۳. چرا فوتبال یک مسئله RL است؟
تقریباً تمام تصمیمهای فوتبالی متوالی هستند:
پاس یا دریبل؟
شوت یا حفظ توپ؟
پرس یا عقبنشینی؟
تعویض یا ادامه بازی؟
حمله مستقیم یا بازی مالکانه؟
هر تصمیم، وضعیتهای بعدی را تغییر میدهد.
۴. مدل مارکوف (MDP)
تقریباً تمام الگوریتمهای RL بر پایه فرایند تصمیمگیری مارکوف (Markov Decision Process) بنا شدهاند.
اجزای اصلی:
حالت (State)
اقدام (Action)
احتمال انتقال (Transition)
پاداش (Reward)
ضریب تنزیل (Discount Factor)
۵. تعریف حالت (State)
در فوتبال، حالت میتواند شامل:
نتیجه بازی
زمان مسابقه
موقعیت توپ
مختصات بازیکنان
تعداد کارتها
خستگی
وضعیت تعویضها
باشد.
۶. تعریف اقدام (Action)
اقدامها میتوانند شامل:
پاس
شوت
دریبل
پرس
تعویض
تغییر آرایش
باشند.
۷. تابع پاداش
مهمترین بخش RL، تعریف پاداش است.
اگر پاداش اشتباه تعریف شود، عامل رفتارهای نامطلوب یاد میگیرد.
در فوتبال، پاداش میتواند ترکیبی از موارد زیر باشد:
گل
جلوگیری از گل
افزایش احتمال برد
ایجاد موقعیت خطرناک
حفظ مالکیت ارزشمند
۸. یادگیری ارزش (Value Function)
مدل یاد میگیرد:
هر وضعیت، در بلندمدت چقدر ارزش دارد.
برای مثال:
مالکیت توپ در یکسوم هجومی ارزش بیشتری از مالکیت در نزدیکی دروازه خودی دارد.
۹. سیاست (Policy)
Policy
تعیین میکند:
در هر وضعیت چه اقدامی انجام شود. هدف RL ، یافتن بهترین سیاست ممکن است.
۱۰. اکتشاف و بهرهبرداری
عامل باید میان دو هدف تعادل برقرار کند:
Exploration
یعنی آزمودن راههای جدید.
و
Exploitation
یعنی استفاده از بهترین راه شناختهشده.
این مسئله یکی از بنیادیترین چالشهای RL است.
۱۱. الگوریتم Q-Learning
یکی از مشهورترین الگوریتمهای RL،
Q-Learning
است.
در این روش، مدل ارزش هر اقدام را در هر وضعیت یاد میگیرد.
۱۲. Deep Q Network (DQN)
با ترکیب Q-Learning و شبکههای عصبی،
DQN
توسعه یافت.
این الگوریتم قادر است وضعیتهای بسیار پیچیده را نیز مدلسازی کند.
۱۳. Policy Gradient
در بسیاری از مسائل فوتبال، فضای اقدام بسیار بزرگ است. در این حالت، روشهای مبتنی بر گرادیان سیاست عملکرد بهتری دارند.
۱۴. Actor-Critic
یکی از موفقترین خانوادههای RL:
Actor-Critic
است.
Actor:
تصمیم میگیرد.
Critic:
کیفیت تصمیم را ارزیابی میکند.
۱۵. Proximal Policy Optimization (PPO)
PPO
یکی از پرکاربردترین الگوریتمهای مدرن RL است.
مزایا:
پایداری آموزش
عملکرد مناسب
پیادهسازی نسبتاً ساده
به همین دلیل در بسیاری از پروژههای تحقیقاتی ورزشی مورد استفاده قرار میگیرد.
. کاربرد در تاکتیک فوتبال
RL
میتواند بیاموزد:
در چه شرایطی:
پرس مؤثرتر است.
ضدحمله ارزشمندتر است.
ارسال از جناح بهتر از بازی عمقی است.
این تحلیلها بر پایه بیشینهسازی پاداش بلندمدت انجام میشوند.
۱۷. ارزشگذاری اقدامات (Action Valuation)
برخلاف آمار سنتی، RL میتواند ارزش واقعی اقدامات بدون توپ را نیز تخمین بزند.
برای مثال:
حرکت یک بازیکن که فضای مناسب برای همتیمی ایجاد میکند، ممکن است ارزش بالایی داشته باشد؛ حتی اگر توپ را لمس نکند.
۱۸. تصمیمگیری مربی
مدل میتواند تصمیمهایی مانند:
زمان تعویض
تغییر سیستم
افزایش فشار
کاهش ریسک
را ارزیابی کند.
البته این به معنای جایگزینی مربی نیست، بلکه ابزاری برای تحلیل سناریوهاست.
۱۹. مدیریت سرمایه
در حوزه شرطبندی، RL میتواند برای تصمیمهای متوالی مانند:
اندازه شرط
زمان ورود به بازار
تخصیص سرمایه
به کار رود.
اما باید توجه داشت که بازارهای واقعی غیرایستا و رقابتی هستند و عملکرد خوب در شبیهسازی الزاماً به موفقیت عملی منجر نمیشود.
۲۰. شرطبندی زنده (In-Play)
در شرطبندی زنده، عامل میتواند پس از هر رویداد:
احتمالها را بهروزرسانی کند.
ارزش مورد انتظار را محاسبه کند.
درباره ورود، خروج یا عدم انجام معامله تصمیم بگیرد.
این کاربرد نیازمند دادههای لحظهای و زیرساخت پردازشی سریع است.
۲۱. شبیهسازی مسابقات
یکی از مهمترین نیازهای RL، وجود محیط شبیهسازی است. در فوتبال، ساخت محیطی که رفتار واقعی بازیکنان، تاکتیکها و تعاملات را با دقت بازتولید کند، بسیار دشوار است.
به همین دلیل، این حوزه همچنان موضوع فعال پژوهش است.
۲۲. یادگیری چندعاملی (Multi-Agent Reinforcement Learning)
فوتبال ذاتاً یک محیط چندعاملی است.
هر بازیکن:
تصمیم مستقل میگیرد.
با همتیمیها همکاری میکند.
با حریف رقابت میکند.
بنابراین، MARL چارچوب طبیعیتری نسبت به RL تکعاملی است.
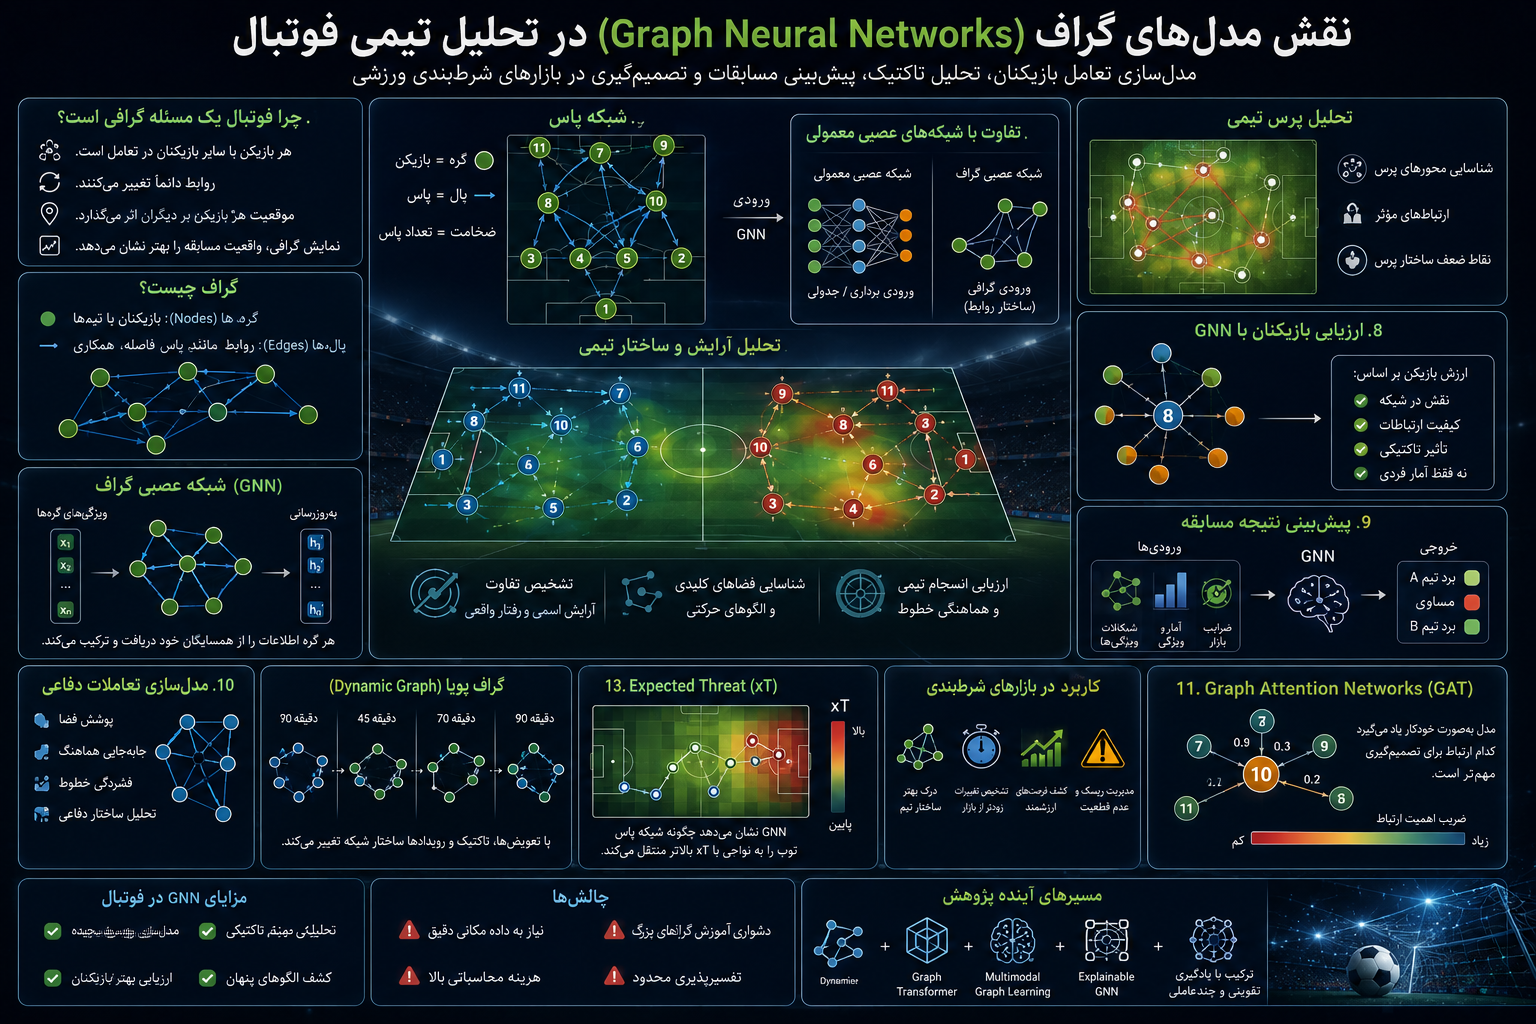
۲۳. ارتباط با Graph Neural Networks
در RL، وضعیت محیط را میتوان با یک گراف نمایش داد.
ترکیب RL و GNN امکان یادگیری تصمیمهای وابسته به ساختار تیم را فراهم میکند.
۲۴. ارتباط با Transformer
Transformer
میتواند وابستگیهای زمانی و الگوهای پیچیده را استخراج کند.
RL
از این نمایشها برای انتخاب اقدام استفاده میکند.
ترکیب این دو معماری یکی از مسیرهای مهم پژوهشی در تحلیل ورزشی است.
۲۵. ارتباط با مدلهای بیزی
مدلهای RL کلاسیک معمولاً عدمقطعیت را مستقیماً مدل نمیکنند.
ترکیب RL با روشهای بیزی میتواند:
میزان اطمینان تصمیمها
ریسک
عدمقطعیت محیط
را بهتر مدیریت کند.
۲۶. محدودیتها
چالشهای اصلی RL عبارتاند از:
نیاز به داده و تعامل بسیار زیاد
هزینه محاسباتی بالا
حساسیت به طراحی تابع پاداش
دشواری انتقال از شبیهسازی به دنیای واقعی (Sim-to-Real Gap)
تفسیرپذیری محدود
ناپایداری برخی الگوریتمها در آموزش
۲۷. آیا RL آینده تحلیل ورزشی است؟
شواهد فعلی نشان میدهد RL در حوزههایی مانند ارزشگذاری اقدامات، تحلیل تاکتیکی و تصمیمگیری متوالی بسیار امیدوارکننده است، اما هنوز جایگزین کامل مدلهای آماری، بیزی یا یادگیری نظارتشده نشده است.
سامانههای آینده از ترکیب RL با مدلهای احتمالاتی، شبکههای گراف، Transformer و سامانههای چندعاملی استفاده خواهند کرد تا از مزایای هر روش بهره ببرند.
یادگیری تقویتی یکی از پیشرفتهترین چارچوبهای تصمیمگیری در هوش مصنوعی است و با ماهیت پویا و متوالی فوتبال همخوانی زیادی دارد. برخلاف مدلهایی که تنها احتمال نتیجه را پیشبینی میکنند، RL بر انتخاب بهترین اقدام در هر وضعیت تمرکز دارد و میتواند در تحلیل تاکتیکی، ارزیابی بازیکنان، تصمیمهای مربیان و مدیریت فرایندهای متوالی کاربرد داشته باشد.
موفقیت RL به طراحی دقیق محیط، تعریف مناسب تابع پاداش، کیفیت داده و اعتبارسنجی علمی وابسته است. در حوزه شرطبندی نیز RL میتواند ابزاری برای پژوهش و بهینهسازی تصمیمگیری باشد، اما هیچ الگوریتمی تضمینکننده سود نیست و بازارهای رقابتی معمولاً مزیتهای ساده را در طول زمان کاهش میدهند.
عکس بساز